
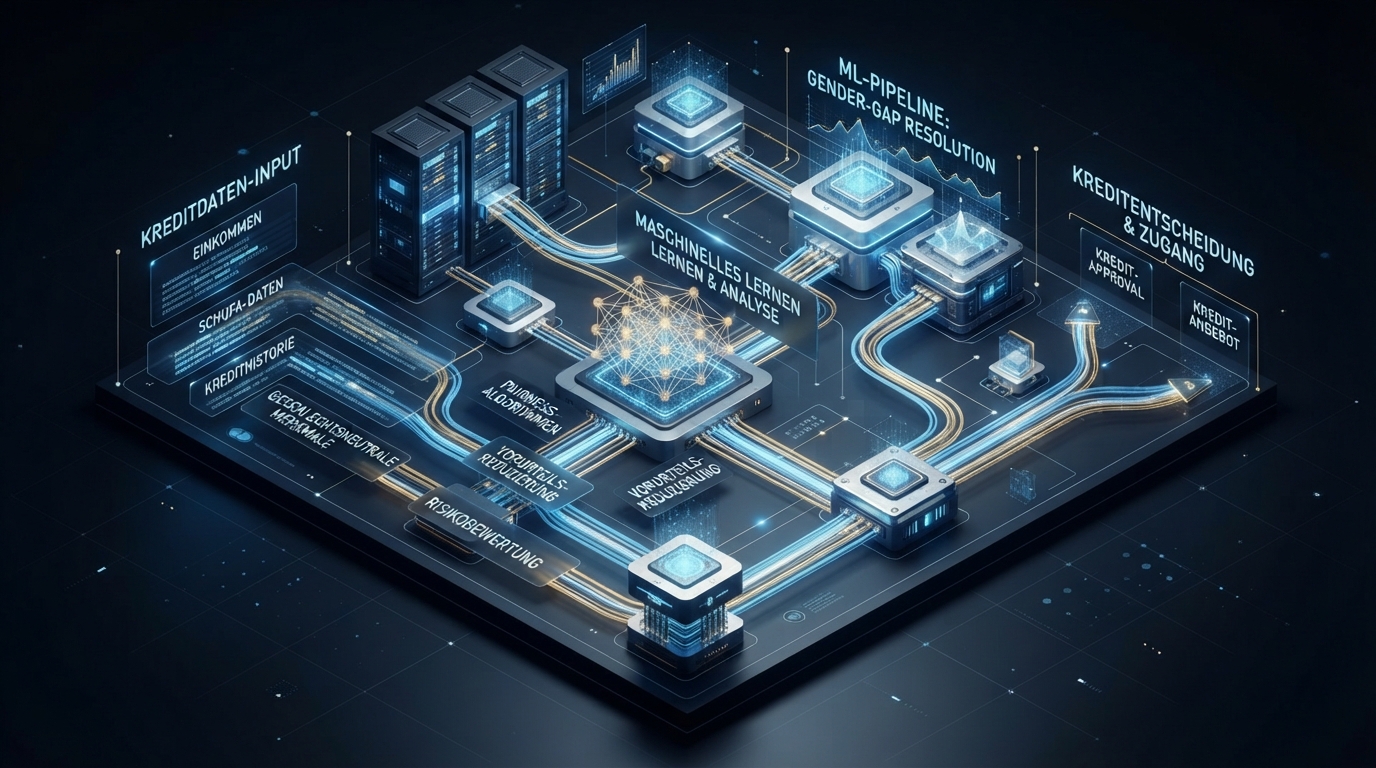
Strukturelle Schieflagen im klassischen Kredit-Scoring
In Schwellenländern wie Mexiko offenbaren traditionelle Kreditvergabesysteme erhebliche architektonische und mathematische Defizite. Konventionelle Scorings basieren primär auf historischen Auskunfteidaten, formalen Gehaltsnachweisen und etablierten Sicherheiten. Da Frauen im lateinamerikanischen Wirtschaftsraum überproportional im informellen Sektor tätig sind oder seltener über traditionelle Bankkonten verfügen, stufen regelbasierte Legacy-Systeme diese Kohorte systematisch als Hochrisiko ein. Die Konsequenz: restriktive Kreditlimite oder ungerechtfertigte Zinsaufschläge – und das, obwohl empirische Rückzahlungsstatistiken bei Kreditnehmerinnen signifikant geringere Ausfallraten (Default Rates) belegen als bei Männern mit vergleichbarem nominalem Score. Für Software-Architekten und Machine-Learning-Engineers im Fintech-Sektor bedeutet dies: Die zugrundeliegenden Datenmodelle und Feature-Pipelines reproduzieren historische Schieflagen, anstatt echte Ausfallwahrscheinlichkeiten abzubilden.
Feature Engineering mit alternativen Datenquellen
Um die Datenarmut im unbanked Segment zu überwinden, setzen moderne Neobanken auf Event-driven Data Pipelines, die alternative Telemetriedaten in Echtzeit ingestieren. Statt ausschließlich statische Kreditauskünfte abzufragen, verarbeiten Streaming-Plattformen über Apache Kafka oder Redpanda aggregierte Zahlungsströme aus Mobilfunktransaktionen, Versorgungsrechnungen (Utilities), E-Commerce-Kaufhistorien und Open-Banking-APIs. Im Feature Store (beispielsweise Feast oder Hopsworks) werden diese Signale in zeitsensitive Verhaltensfeatures transformiert, wie etwa die Konsistenz mikroskopischer Cashflows oder das Verhältnis von wiederkehrenden Rechnungsbegleichungen zu Gesamtausgaben. Die Herausforderung besteht darin, Proxy-Variablen für das Geschlecht (wie spezifische Händlerkategorien oder Geo-Cluster) rechnerisch zu isolieren, um eine indirekte Diskriminierung durch multivariate Korrelationen zu unterbinden.
Fairness-Optimierung im Modelltraining
Standardmodelle wie Gradient-Boosted Decision Trees (XGBoost, LightGBM) maximieren im Default-Zustand Metriken wie ROC-AUC oder Log-Loss, wodurch sie vorhandene Label-Verzerrungen ungefiltert adaptieren. Fintech-Entwickler implementieren daher zunehmend Debiasing-Methoden direkt in die Trainingspipeline. Hierbei kommen In-Processing-Techniken zum Einsatz, die Fairness-Constraints wie Equalized Odds (Chancengleichheit bei True-Positive- und False-Positive-Raten) oder Demographic Parity über Lagrangesche Multiplikatoren direkt in die Verlustfunktion einbetten.
from fairlearn.reductions import ExponentiatedGradient, EqualizedOdds
from lightgbm import LGBMClassifier

# Basis-Klassifikator für Kreditausfallwahrscheinlichkeit
base_estimator = LGBMClassifier(n_estimators=200, max_depth=5, learning_rate=0.03)

# Constraint-basierte Optimierung zur Eliminierung von Geschlechter-Biases
mitigator = ExponentiatedGradient(
    estimator=base_estimator,
    constraints=EqualizedOdds(difference_bound=0.02),
    eps=0.005
)

# sensitive_features markiert geschlechtsspezifische Attribute isoliert vom Inferenz-Pfad
mitigator.fit(X_train, y_train, sensitive_features=gender_train)
fair_scoring_model = mitigator.predictors_
Explainability und regulatorische Compliance im Inferenzpfad
Ein zentraler Trade-off bei alternativen Scoring-Architekturen liegt zwischen Modellkomplexität und Nachvollziehbarkeit. Regulierungsbehörden – wie die mexikanische Banken- und Wertpapierkommission (CNBV) – fordern bei Kreditentscheidungen klare Begründungen für Ablehnungen (Adverse Action Notices). Black-Box-Modelle sind in diesem Kontext regulatorisch untragbar. Ingenieure integrieren daher TreeSHAP (SHapley Additive exPlanations) direkt in den Serving-Layer, um lokale Attributionen im Sub-Sekunden-Bereich zu berechnen. So lässt sich exakt quantifizieren, welche Features zu einer Zinsanpassung geführt haben. Das System generiert automatisch kontrafaktische Erklärungen (Counterfactual Explanations), die Antragstellern aufzeigen, welche metrischen Änderungen (z. B. eine lückenlose dreimonatige Begleichung von Stromrechnungen) für eine Zinsreduktion erforderlich sind.
MLOps-Monitoring: Fairness Drift in Produktion überwachen
Die Implementierung eines fairen Modells endet nicht beim Deployment. MLOps-Architekturen müssen neben klassischen Drift-Parametern (Data Drift via Wasserstein-Distanz, Concept Drift via Population Stability Index) auch expliziten Fairness Drift auditieren. Verändert sich die demografische Zusammensetzung der Nutzerbasis oder passen sich Verhaltensmuster an, kann die Disparate-Impact-Ratio (DIR) im laufenden Betrieb degradieren. Plattform-Teams instrumentieren Inferenz-Endpunkte mit Open-Telemetry-Metriken und kontinuierlichen Evaluierungs-Jobs, die aggregierte Vorhersagewahrscheinlichkeiten gruppenspezifisch tracken. Ergibt der DIR-Score für sensible Gruppen einen Wert unterhalb des Schwellenwerts von 0,8, wird automatisiert ein Alerting ausgelöst, das Retraining-Pipelines anstößt oder Transaktionen in eine deterministische manuelle Prüfung überführt.