
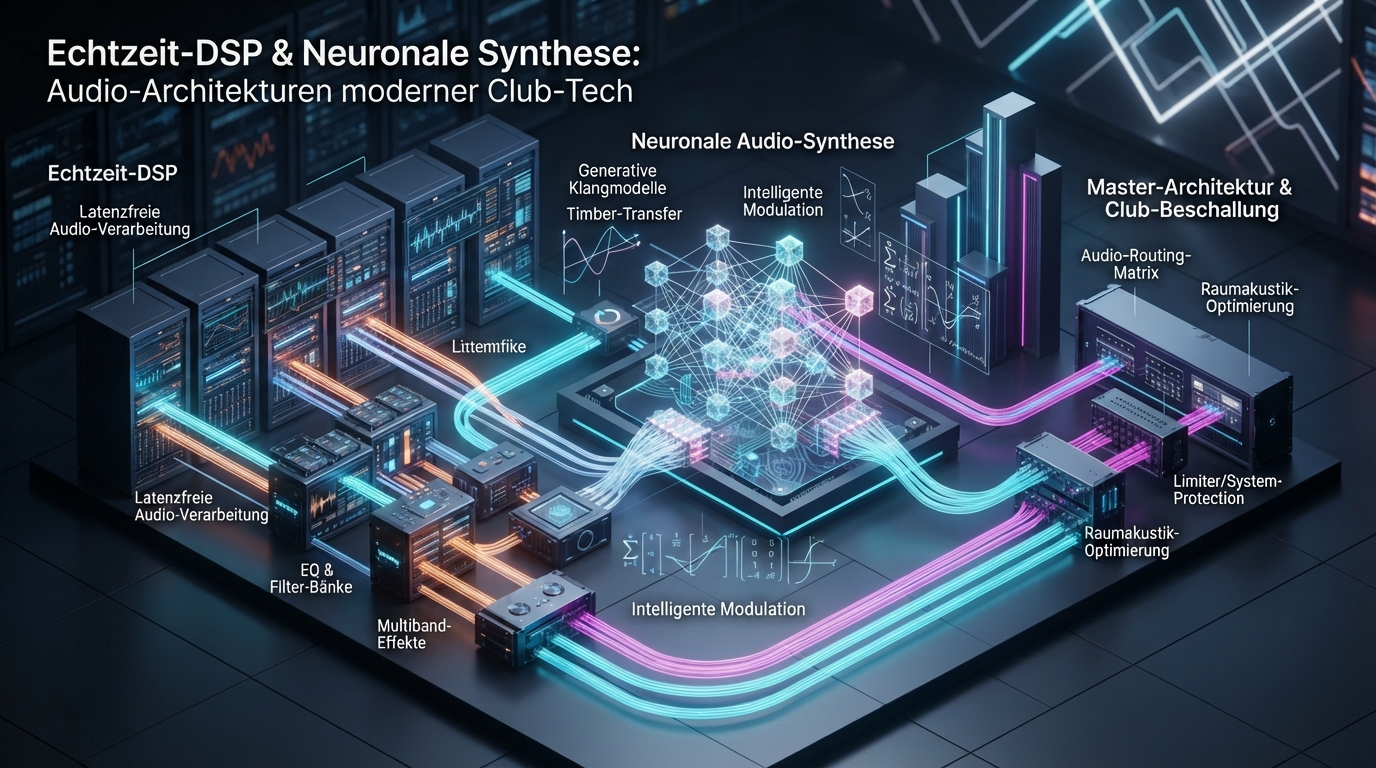
Akustische Signalverarbeitung trifft auf Deep Learning
Während elektronische Künstlerinnen wie die niederländische DJ und Produzentin KI/KI im renommierten DJ-Mag-Top-100-Ranking gefeiert werden, vollzieht sich hinter den Reglern digitaler Mischpulte und Workstations eine fundamentale technische Transformation. Das Kürzel, das in der Tech-Welt seit jeher für Machine Learning steht, markiert in der modernen Musiktechnologie einen architektonischen Paradigmenwechsel: Die traditionelle Signalverarbeitung (Digital Signal Processing, DSP) verschmilzt zunehmend mit Inferenzmodellen für generative Audiosynthese und echtzeitfähige Quellentrennung.
Latenz-Budgets im Millisekundenbereich: Die Audio-Thread-Herausforderung
Live-Audio-Applikationen stellen Software-Architekten vor rigide Randbedingungen, die sich drastisch von klassischen REST- oder Microservice-Paradigmen unterscheiden. Ein gängiger Audio-Buffer umfasst 64 bis 128 Samples bei einer Abtastrate von 48 kHz. Das bedeutet für den Inferenz-Zyklus ein unnachgiebiges Zeitfenster von lediglich 1,33 bis 2,66 Millisekunden. Jede Überschreitung führt zu unweigerlichen Pufferunterläufen (Buffer Underruns) und hörbaren Dropouts.
Python-basierte Deep-Learning-Frameworks wie PyTorch sind für diese Ausführungsumgebungen ungeeignet, da der Global Interpreter Lock (GIL) und Garbage-Collection-Zyklen Deadlines im Echtzeit-Audio-Thread kompromittieren. Moderne Architekturen setzen daher auf dedizierte C++- und Rust-Pipelines, integriert in Frameworks wie JUCE, bei denen Inferenzmodelle über ONNX Runtime oder LibTorch C++ in lock-freien Ringspeichern asynchron zur Audio-Engine ausgeführt werden.
// Lock-free Ring-Buffer Schema für asynchrone Audio-Inferenz
template <typename T, size_t Capacity>
class AudioInferenceRingBuffer {
    std::array<T, Capacity> buffer_;
    std::atomic<size_t> head_{0};
    std::atomic<size_t> tail_{0};
public:
    bool pushAudioChunk(const T* input, size_t size) {
        // Realtime-Thread: Kein Lock, kein Allocator
        size_t current_head = head_.load(std::memory_order_relaxed);
        if ((current_head + size) - tail_.load(std::memory_order_acquire) > Capacity) {
            return false; // Buffer Overflow abfangen
        }
        std::memcpy(&buffer_[current_head % Capacity], input, size * sizeof(T));
        head_.store(current_head + size, std::memory_order_release);
        return true;
    }
};
Echtzeit-Stammtrennung: Faltungskerne und U-Nets auf Kante genäht
Ein Kernbereich moderner DJ-Technologie und Live-Remixing-Engines ist das Zero-Shot-Stem-Separation-Verfahren. Architekturen, die auf Varianten von Demucs oder Spleeter basieren, separieren in Sekundenbruchteilen Kickdrums, Bassspuren, Synth-Leads und Vocals. Um diese speicherintensiven Faltungs- und Transformer-Netze auf mobilen Prozessoren (wie Apple Silicon M-Series oder x86-Laptops) performant auszuführen, setzen Entwickler auf aggressive Modellquantisierung (INT8/FP16) und hardwarenahe SIMD-Vektorisierung (AVX-512, Neon).
- Speicherallokation: Strikte Null-Allokations-Politik im Audio-Render-Callback zur Vermeidung von Page-Faults.
- Parallelisierung: Auslagerung der spektralen STFT-Transformationen (Short-Time Fourier Transform) auf separate Worker-Threads via Lock-Free FIFO.
- Kompression: Quantisierung von Gewichtsmatrizen mittels Post-Training Quantization (PTQ) zur Reduktion des RAM-Footprints auf eingebetteten DJ-Mediaplayern.
Neuronale VAEs: Latenzfreie Klangerzeugung mit RAVE
Für generative Eingriffe direkt im Club-Setup etabliert sich das RAVE-Modell (Realtime Audio Variational autoEncoder). Im Gegensatz zu autoregressiven Ansätzen dekodiert RAVE latente Vektoren direkt in rohe Wellenformen und erzielt auf handelsüblicher Hardware Inferenzzeiten von unter einer Millisekunde. Software-Entwickler binden derartige Modelle zunehmend als VST3- oder CLAP-Plugins ein, wodurch Künstler wie Produzenten bestehende Spuren on-the-fly modifizieren und timbre-mäßig transformieren können.
Architektur-Fazit für Systems- und Audio-Engineers
Die Verschmelzung von Club-Kultur, dargestellt durch Meilensteine wie das DJ-Mag-Ranking, und maschinellem Lernen verdeutlicht: Audio-Software hat sich von rein heuristischer Signalverarbeitung zu datengetriebenen Hybrid-Systemen weiterentwickelt. Für Software-Ingenieure bedeutet dies, dass maschinelles Lernen nicht mehr nur im Rechenzentrum stattfindet, sondern direkt an der harten 2-Millisekunden-Grenze der Hardware-Echtzeit gemeistert werden muss. Wer robuste Audioprodukte der nächsten Generation baut, muss lock-freie Datenstrukturen ebenso beherrschen wie Tensor-Kompression und hardwarebeschleunigte Inferenz-Runtimes.